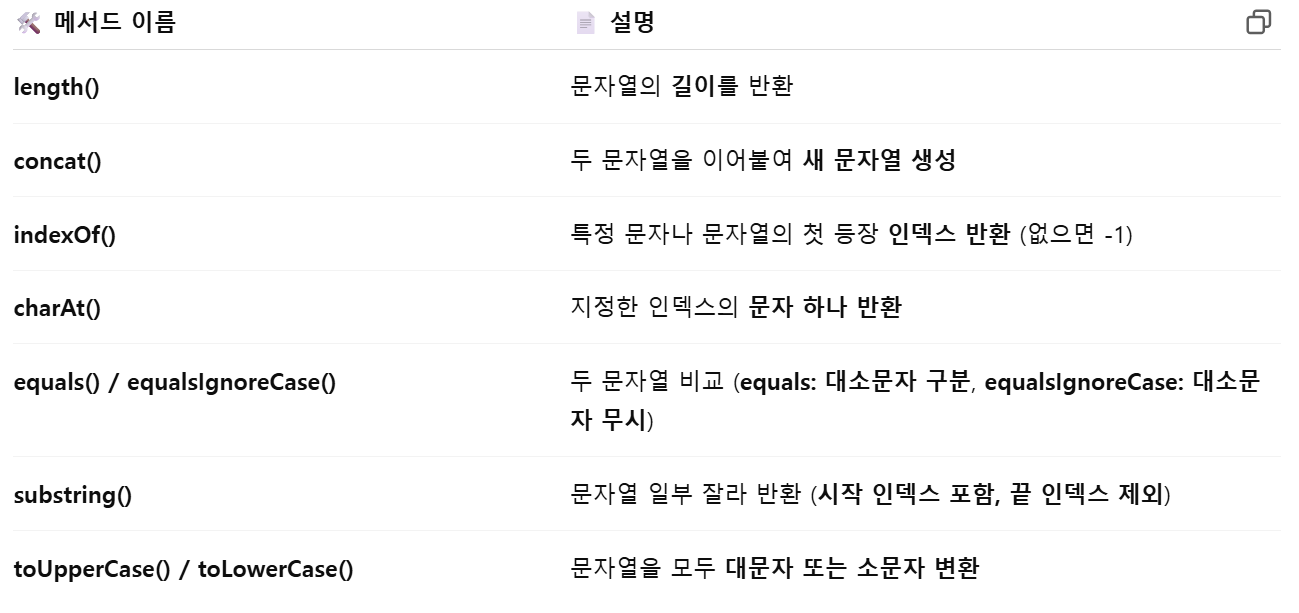
4. String method
자바에선 String이 쓰는 method 가 있다!
concat()
String name = new String("Code");

name = name.concat("cademy");

System.out.println(name);
concat은 String을 결합해주는 method이기 때문에 codecademy 가 출력된다.
*Java에서 String 객체는 한번 만들면 그 값을 변경할 수 없다.*
바뀌었잖아요? 라고 질문한다면
바뀐게 아니라 새로 생긴것을 다시 참조한 것이다.
첫 줄에서 String 변수 name은 new로 생성된 "Code" String 객체를 참조한다.
그다음 concat()을 통해 name에 "cademy"를 결합하면, 새로운 문자열 객체 "Codecademy"가 생성되고,
=을 통해 name에 이 새로운 문자열 객체를 대입하면 name이 새 객체를 참조하도록 바꾼다.
바꾸는게 아니라 새롭게 생기는 것이기 때문에 대입이 필요한 것!
문자열(String)과 다른 객체를 concat() 으로 연결하면 다른 객체의 toString() method 실행 결과를 문자열에 붙인다.
toString() method는 해당 객체를 String으로 변환한다.
✅ 요약:
- concat()은 단순히 메모리 주소를 이어붙이는 게 아니다.
- 연결 대상이 String이든 다른 Object이든, 결국 toString() 결과를 붙인다.
- String은 자기 자신을 문자열로 반환하기 때문에 String끼리는 자연스럽게 동작
String을 비교하고싶다면?
equals()
String flavor1 = "Mango";
String flavor2 = "Peach";

System.out.println(flavor1.equals("Mango"));
// prints true

System.out.println(flavor2.equals("Mango"));
// prints false
String은 비교할때 ==을 쓰지 않는다 .equals() method를 사용한다.
=> true false 값 출력
equalsIgnoreCase()
대소문자를 무시하고 문자열을 비교
compareTo()
문자열을 사전 순서로 비교한다!
compareTo() 작동 방식:
- 각 문자열의 문자를 유니코드 값으로 변환해서 비교
- 반환값은 int로, 두 문자열의 차이를 출력
String flavor1 = "Mango";
String flavor2 = "Peach";

System.out.println(flavor1.compareTo(flavor2));  // -3
이유: 'P'가 'M'보다 3 큼
반환 값 해석
- 0 → 두 문자열이 같다.
- 0보다 작음 → 비교하는 문자열(this)이 인자로 주어진 문자열보다 사전적으로 작다.
- 0보다 큼 → 비교하는 문자열(this)이 인자로 주어진 문자열보다 사전적으로 크다.
⚠️ 주의할 점
- compareTo()는 대소문자를 구분!!
예:
"Mango".compareTo("Peach") → -3
"mango".compareTo("Peach") → 29 (소문자 'm' 유니코드 값이 대문자 'P'보다 큼)
compareToIgnoreCase()
대소문자를 무시하고 compareTo()와 같은 비교
문자열은 index가 존재한다!
문자열에서 특정 문자의 index가 궁금하다면???
indexOf()
문자열에서 특장 문자나 sub문자열이 처음 시작하는 위치(index) 를 찾아준다.
String letters = "ABCDEFGHIJKLMN";
System.out.println(letters.indexOf("C"));
여기서 결과는 2가 나온다. 인덱스상 위치가 0 1 2 로 C는 index 2가 나온다.
문자열 뿐만 아니라 부분문자열이 어디서 시작하는지도 찾을 수 있다!
System.out.println(letters.indexOf("EFG"));
E는 인덱스 4에 위치하고 있기 때문에 4가 출력된다.
찾는 문자가 존재하지 않으면? -> -1
System.out.println(letters.indexOf("Z"));해당 문자열에 Z가 없기 때문에 -1이 출력된다.
전 위치 말고 해당 위치의 문자를 가지고싶은데요 ?
charAt()
이 메소드는 반대로 해당 index에 위치한 chracter를 출력한다.
String str = "qwer";

System.out.println(str.charAt(2));
index 2에 위치한 e가 출력된다.
여기서 4를 입력하면 index 4가 존재하지 않기 때문에 out of range 에러 발생
알파벳 말고 부분문자열을 가지고 싶다면?
substring()
문자열의 일부분만 잘라서 가져오고 싶을 때
String line = "The Heav'ns and all the Constellations rung";

System.out.println(line.substring(24));
인덱스 24번부터 끝까지 출력한다.
substring(숫자1,숫자2)
=> 숫자1~ 숫자2 직전까지 출력한다.
System.out.println(line.substring(27, 33));
인덱스 27부터 32까지 잘라와서 출력한다.
주의: 첫 번째 숫자는 포함, 두 번째 숫자는 미포함
한 글자만 뽑아오기 → substring(인덱스, 인덱스 + 1)
System.out.println(line.substring(24, 25));→ 인덱스 24~24 한 글자 (C) 만 출력.
모두 대문자로 바꾸기, 모두 소문자로 바꾸기 하고싶어요!
toUpperCase() / toLowerCase()
toUpperCase() : 대문자로 출력하고 싶을 때
toLowerCase() : 소문자로 출력하고 싶을 때
String input = "Cricket!";

String upper = input.toUpperCase();
// stores "CRICKET!"

String lower = input.toLowerCase();
// stores "cricket!"
언제 쓰면 좋을까??
사용자가 입력한 데이터를 데이터베이스에 저장할 때 전부 소문자로 통일하면 나중에 검색하거나 비교할 때 훨씬 편해짐
예:
- 유저가 Apple, apple, APPLE 이렇게 입력해도 → 전부 apple로 저장하면 검색할 때 “apple” 하나만 찾아도 됨.
=> 실무에서는 데이터 일관성 맞추는 데 많이 씀
최종정리!